Fractalium
Application C++/Qt de calcul distribué de fractales via MPI : zoom interactif, précision 100 décimales, snapshots de session et exécution sur cluster.
Configuration électronique
- 1s C++
- 1s Qt
- 2p MPI
- 2p CMake
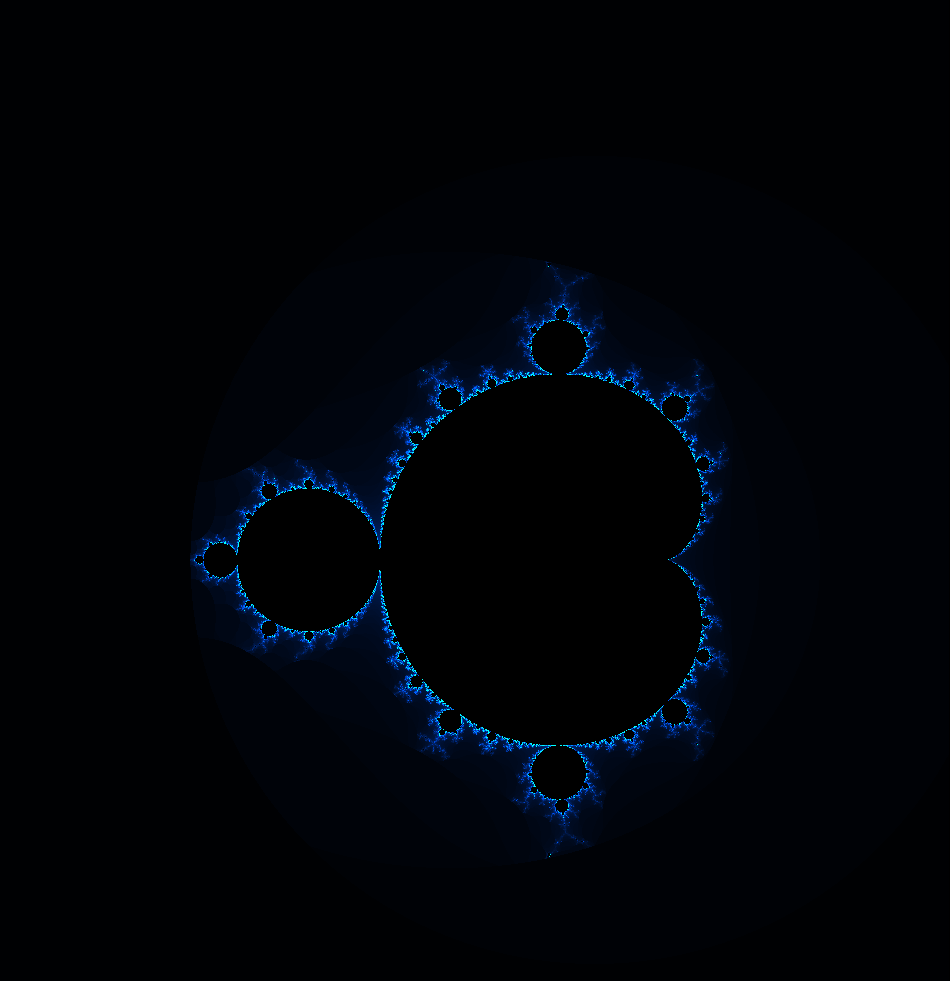 Ensemble de Mandelbrot calculé par Fractalium
Fractalium calcule et affiche des fractales en répartissant le travail sur plusieurs machines avec MPI. On sélectionne une zone à la souris, et l'image zoomée est recalculée par tout le cluster. Projet de Master réalisé avec Maxime Colliat, conçu pour tourner sur les machines des salles de TP de l'université.
En bref
- Contexte : projet universitaire de calcul distribué, Master 1 Informatique, 2023-2024.
- Stack : C++23, MPI (Boost.MPI), Qt, Boost.Multiprecision, CMake, Python.
- Équipe : 2 personnes.
Liens
Le sujet
Une fractale se calcule pixel par pixel, et chaque pixel est indépendant des autres. C'est un cas idéal pour le calcul parallèle : on découpe l'image, chaque machine calcule son morceau, et on recolle les résultats.
Ce que fait l'application
- Cinq fractales : Mandelbrot, Julia, Burning Ship, et deux variantes de Newton.
- Zoom par sélection rectangulaire, avec un historique pour revenir en arrière.
- Une précision de 100 décimales, pour zoomer très loin sans que l'image se dégrade.
- Sept palettes de couleurs et une résolution réglable jusqu'à 5120 pixels de large.
- Sauvegarde et chargement de sessions complètes, et récupération automatique après un plantage.
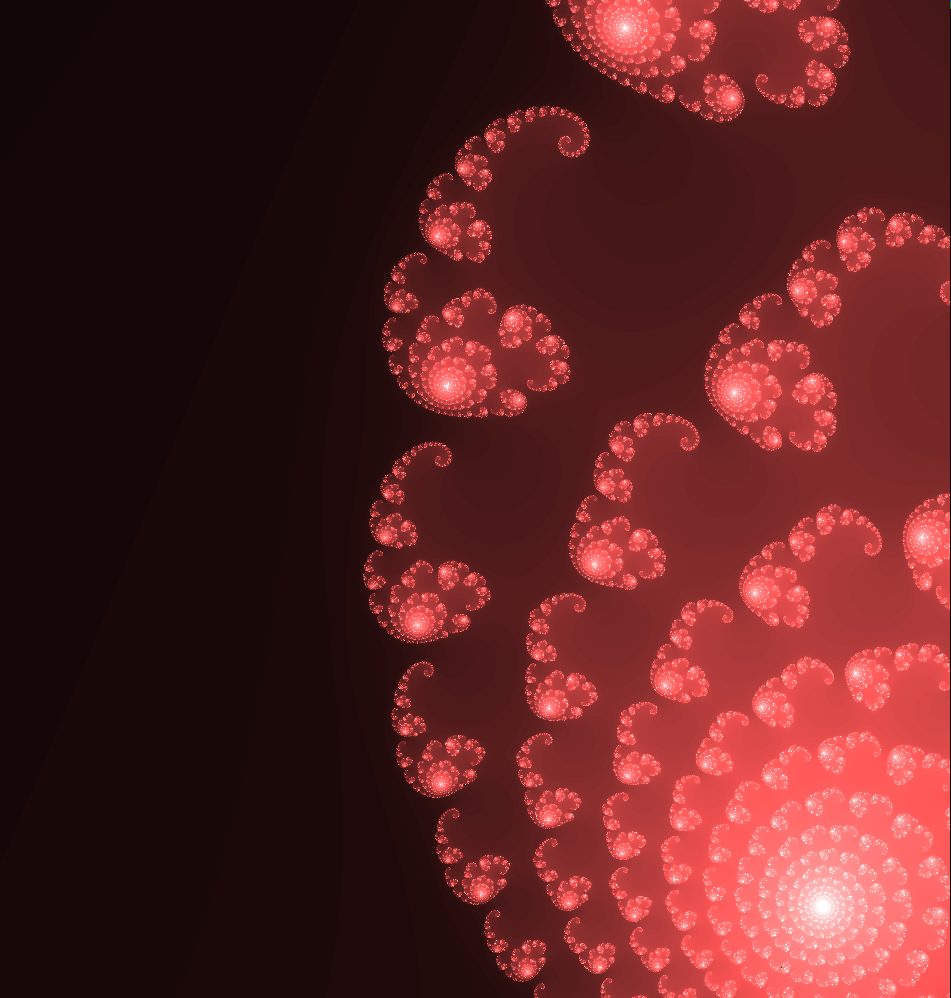 Julia
Comment c'est construit
- Un maître et des travailleurs : le processus MPI de rang 0 affiche l'interface Qt ; les autres attendent du travail. À chaque zoom, le maître découpe l'image en bandes verticales ou en carrés selon le nombre de machines, envoie chaque morceau, puis assemble les images reçues.
- Boost.MPI et Boost.Serialization évitent de décrire à la main les types de données MPI : les structures sont sérialisées automatiquement.
- Précision arbitraire : un
doublene garde qu'une quinzaine de chiffres significatifs, ce qui ne suffit plus après quelques zooms. Les calculs utilisentcpp_dec_float_100de Boost. - Rendu sans bloquer l'interface : quand toutes les zones sont arrivées, un événement Qt est envoyé au fil de l'interface, qui colore l'image avec la palette choisie.
- Reprise après plantage : les signaux fatals (
SIGSEGV,SIGABRT…) sont interceptés pour sauvegarder la session avant de quitter, et l'application propose de la recharger au démarrage suivant. - Découverte du cluster : un script Python teste en parallèle l'accès SSH à une soixantaine de machines, compte leurs cœurs et génère le fichier d'hôtes MPI.
Le code est documenté avec Doxygen, et un workflow GitHub Actions compile et publie une version Linux.
Limites
- Pas de tests automatisés : les résultats sont vérifiés visuellement.
- Le calcul en précision arbitraire est beaucoup plus lent qu'en
double, même réparti.
Ce que le projet montre
- Le découpage d'un calcul sur un cluster avec MPI.
- L'intégration d'un calcul distribué dans une interface graphique réactive.
- La gestion de la précision numérique pour les zooms profonds.